




Сегодня большие языковые модели (LLM) становятся основой для целых классов продуктов — от интеллектуальных ассистентов до аналитических систем и рекомендательных движков. Крупные корпорации повсеместно внедряют масштабные LLM, но быстро сталкиваются с проблемами: развитие и поддержка таких моделей требуют огромных мощностей и устойчивости системы. Александр Кротов, эксперт в области оптимизации нейросетевых инфраструктур, рассказал о том, какие подходы использовать в масштабных
В чем проблема использования LLM в корпорациях
Крупные компании ежедневно оперируют тысячами процессов. Если выполнять их вручную, это займет массу времени — и не исключены ошибки из-за человеческого фактора. Одна ошибка не будет стоить слишком дорого, но если каждый день их сотни, то это значительно скажется на общей выручке.
Поэтому корпорации используют масштабные LLM, чтобы автоматизировать процессы и минимизировать человеческий фактор. AI-агенты могут применяться как для простых задач — например, суммаризации документов, ответов на простые обращения или генерации контента — так и для сложных последовательностей действий (tool calls). Они тоже могут ошибаться, но на этот раз более-менее стабильно, одинаково при обучении и в продакшене.
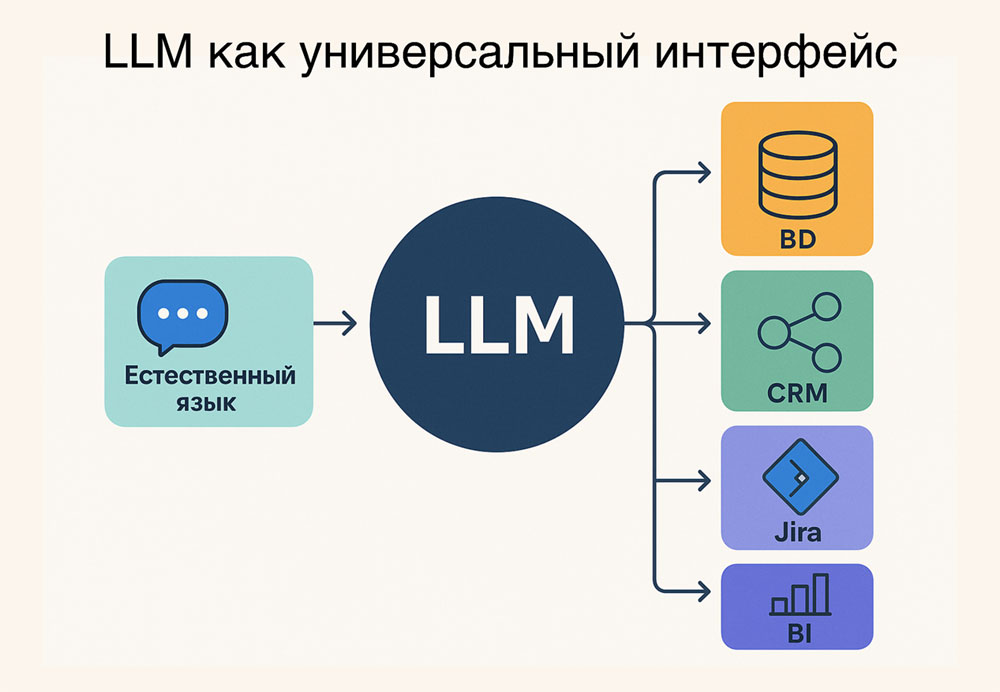
Так, LLM могут запускать внутренние скрипты, запрашивать базы данных, управлять CRM, создавать задачи в Jira или анализировать отчёты BI. По сути, модели становятся универсальным интерфейсом к корпоративным системам. Раньше для таких задач приходилось разрабатывать отдельные интерфейсы, продумывать взаимодействие во всех возможных сценариях, но теперь, работая с LLM, все проще — модели знают контекст, понимают естественный язык и умеют вызывать внешние функции.
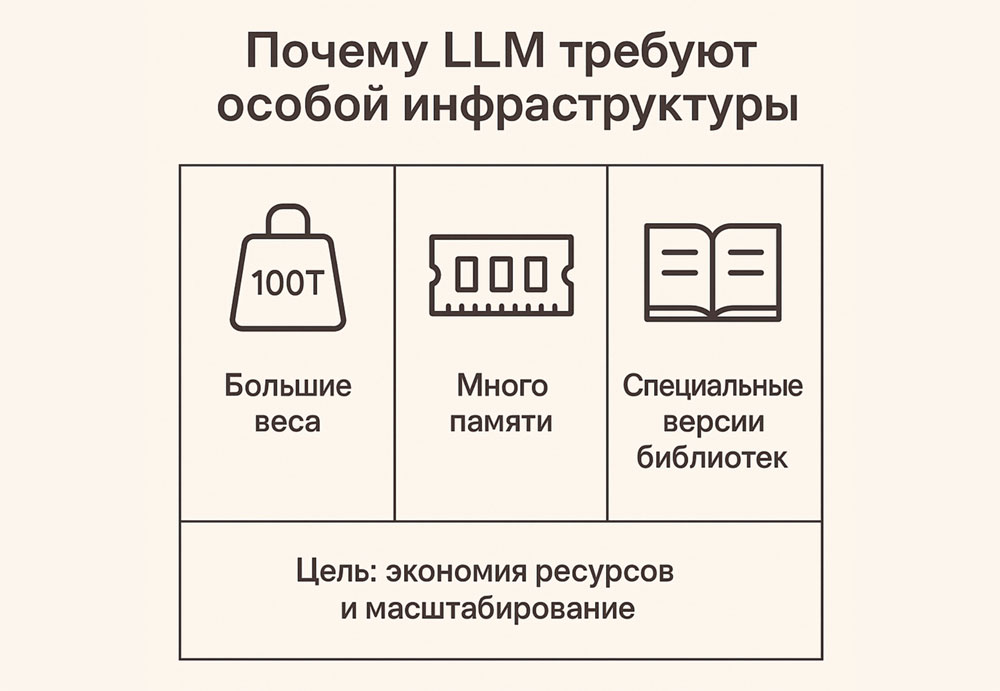
Но среди всех плюсов LLM есть один минус — их большой размер и ресурсоемкость. Им нужны GPU-ресурсы, обширные объемы памяти, отдельные пайплайны для загрузки весов моделей и специфические версии библиотек. Поэтому построение инфраструктуры для масштабной LLM требует особого подхода. Нужно продумать архитектуру проекта, чтобы обеспечить максимальную экономию ресурсов — так будет проще масштабировать проект. И еще необходимо обеспечить скорость и стабильность системы даже при высоких нагрузках.
Принципы построения инфраструктуры для LLM
Главный принцип — обеспечение стабильности и отказоустойчивости системы. Крупные LLM работают на аппаратном обеспечении, которого обычно ограниченное количество — поэтому долгий даунтайм даже одного пода или инстанса может сказаться на работе системы. В отличие от обычных сервисов, где перезапуск занимает секунды, восстановление LLM требует времени: нужно заново загрузить большие веса модели, прогреть кэш и вернуть сервис в строй.
Также LLM отличаются долгим временем выполнения запросов. Например, при падении обычного сервиса, который загружает выборку из базы данных, на повтор запроса уйдет менее 100 миллисекунд, а в случае LLM придется повторить 30 секунд вычислений. В масштабах тысяч одновременных пользователей это превращается в серьезный риск деградации сервиса. Поэтому стоит добиваться максимальной отказоустойчивости системы, чтобы такого не происходило.
При этом инференс LLM — это обычно листовой сервис, который выполняет исключительно вычислительные задачи. Он не обращается к внешним системам и не взаимодействуют с базами данных. Благодаря этому поверхность для потенциальных уязвимостей минимальна, и обеспечить базовую безопасность проще.
Infrastructure as Code как оптимальный подход для работы с LLM-проектами
Инфраструктура как код (Infrastructure as Code, IaC) — это методология управления и развертывания IT-инфраструктуры, основанная на принципе описания всех ее компонентов в виде программного кода. Таким образом, конфигурации серверов, сетевых параметров, баз данных, кластеров и других ресурсов фиксируются в виде декларативных или процедурных файлов, что обеспечивает воспроизводимость, прозрачность и автоматизацию инфраструктурных процессов.
IaC позволяет отказаться от ручного управления инфраструктурой: все операции по созданию, изменению и удалению ресурсов выполняются автоматически на основании кода. Инженер описывает требуемое состояние системы, а специализированные инструменты (например, Terraform, Ansible, Puppet, AWS CloudFormation и др.) приводят фактическую инфраструктуру в соответствие с этим описанием.
Изменения вносятся централизованно — через редактирования кода, что гарантирует синхронизацию и согласованность окружений. Такой подход обеспечивает воспроизводимость, версионирование, надежность за счет отсутствий человеческого фактора и масштабируемость.
В проектах, связанных с масштабными LLM, подход Infrastructure as Code позволяет описывать и контролировать сложную инфраструктуру как единую систему. Это позволяет обеспечить предсказуемость, снизить риск конфликтов в системе и автоматизировать процессы, что оптимизирует нагрузку на команду эксплуатации. К тому же, подход IaC отлично подходит для шаблонизирования работы с множеством однотипных
Как сохранить стабильность LLM
Для сохранения стабильности уже работающего сервиса нужно соблюдать те же правила, что и обычно — настроить автомониторинг и алертинг, обеспечивать observability, собирать метрики, логи и трейсы, следить за здоровьем используемого аппаратного обеспечения. Эти меры позволят своевременно выявлять деградации производительности и предотвращать инциденты, влияющие на доступность сервиса.
Качество и скорость моделей необходимо регулярно тестировать, но в масштабных LLM это сопряжено с некоторыми сложностями. Из-за высокой стоимости аппаратного обеспечения сложно проводить зеркалирование трафика — тестируемая модель может весить десятки гигабайт, и держать вторую копию в активном состоянии экономически нецелесообразно. Сanary release тоже не подойдет, так как откат может быть слишком медленным из-за большого веса модели.
Поэтому тестирование качества и скорости моделей обычно выносится в отдельное окружение, а новая версия допускается в продакшн-среду только после успешной валидации. В целом, с масштабными LLM нежелательно проводить эксперименты в продакшене, которые можно было бы использовать при работе с другими сервисами.
Как автоматизировать работу с LLM
При работе с LLM имеет смысл автоматизировать деплой, так как современные фреймворки для исполнения постоянно совершенствуются — повышают производительность, снижают нагрузку на GPU и позволяют эффективнее использовать вычислительные ресурсы. Всё это позволяет экономить дорогое аппаратное обеспечение: система может регулярно обновлять окружение и получать выгоду от оптимизаций без участия инженеров.
Однако автоматизация требует высокой степени контроля. Перед каждым обновлением необходимо гарантировать корректность работы моделей — их совместимость с новой версией фреймворка, стабильность метрик и соответствие ожидаемому качеству ответов. Неконтролируемое обновление может привести к деградации модели или нестабильности в продакшне, поэтому автоматический деплой допустим только после прохождения всех этапов тестирования.
Процесс отката (rollback), наоборот, чаще выполняется вручную. Большая часть потенциальных проблем выявляется еще до выкатки, а непредвиденные ситуации требуют анализа и валидации у специалиста. При этом использование подхода Infrastructure as Code значительно упрощает восстановление системы: все состояния сервисов зафиксированы в коде, и возврат к предыдущей стабильной конфигурации может быть выполнен быстро, без сложных ручных операций.
Таким образом, автоматизация эксплуатации инфраструктуры LLM — это баланс между скоростью обновлений и контролем качества. Полная автономия здесь невозможна: система должна быть достаточно гибкой, чтобы быстро внедрять улучшения, но при этом оставлять инженеру контроль над безопасностью и устойчивостью инфраструктуры.