





Специализируется на тестировании банковских и микросервисных систем, интеграционных проверках и управлении QA-процессами.
В тестировании микросервисов есть неприятная ловушка: команда проверила API, убедилась, что сообщение ушло в Kafka, посмотрела логи — все нормально. А потом выясняется, что бизнес-операция так и не завершилась.
Начинается разбирательство. Первый сервис запрос принял. Второй сообщение получил. Третий записал данные в базу. У каждого по отдельности есть основания утверждать, что его компонент работает правильно. Только клиенту от этого не легче: нужного результата он не получил.
В банковских проектах такие ситуации особенно опасны. Неправильно обработанный статус, сумма или идентификатор операции могут затронуть расчеты, выплаты и работу смежных систем. При оценке готовности релиза меня в первую очередь интересует, что произойдет со всей бизнес-операцией после выпуска. Результаты тестов измененного сервиса — только часть ответа.
Если сервис работает, но его взаимодействие с потребителями не проверено, готовность продукта остается под вопросом.
Когда успешный ответ ничего не решает
Разберем технический сценарий. Он условный, но хорошо показывает, как возникает дефект на границе двух сервисов.
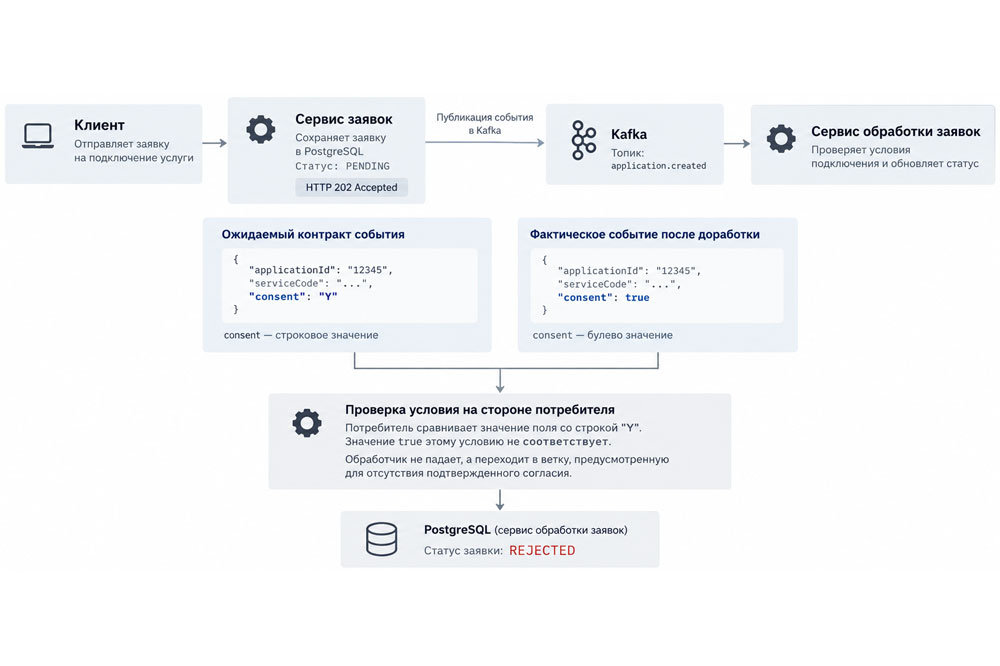
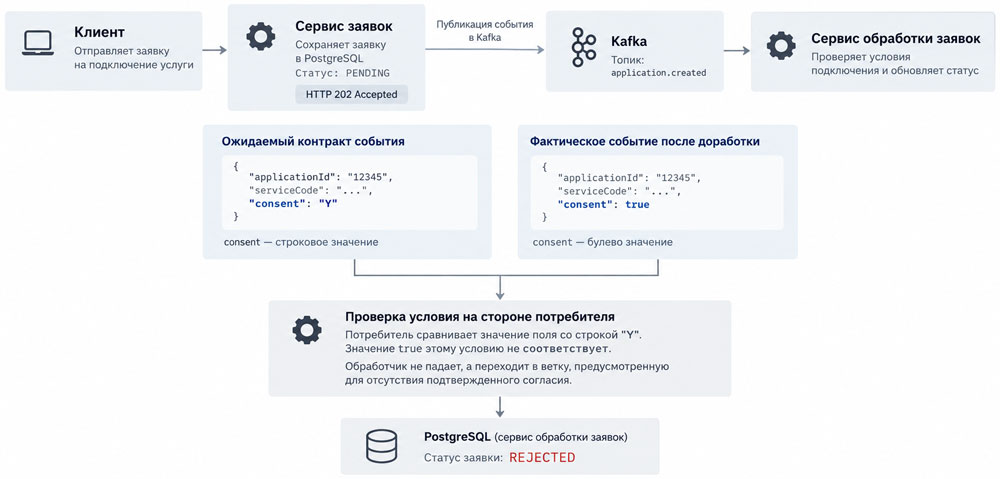
Клиент отправляет заявку на подключение банковской услуги. Сервис заявок принимает запрос, сохраняет данные в базу данных PostgreSQL со статусом PENDING и возвращает HTTP 202 Accepted. Ответ подтверждает прием заявки, но не завершение подключения.
Затем сервис публикует в Kafka событие application.created. Его получает сервис обработки заявок, проверяет условия подключения и обновляет статус.
В событии есть идентификатор заявки, код услуги и признак согласия клиента. По действующему контракту последний передается строкой:
«consent»: «Y»
При доработке сервис заявок начинает отправлять значение типа boolean
«consent»: true
На первый взгляд изменение незначительное. Новый формат даже выглядит логичнее. Сервис заявок формирует событие без ошибок, Kafka принимает его, потребитель получает сообщение.
Но потребитель по-прежнему проверяет строгое равенство поля строке «Y». Значение true этому условию не соответствует. Обработчик не падает: он просто переходит в ветку, предусмотренную для отсутствия подтвержденного согласия, и сохраняет статус REJECTED.
В итоге клиент видит, что заявка принята, но услуга не подключена. Самое неприятное — технически каждый этап может завершиться успешно. API ответил, сообщение опубликовано, потребитель выполнил обработку, запись в базе обновилась. Ошибок в логах может вообще не быть.
Kafka и доступность сервисов здесь ни при чем. Отправитель изменил представление данных, не обеспечив совместимость с потребителем, и бизнес-логика нарушилась.
В системах с реестром схем и проверкой совместимости такое изменение заблокировали бы еще на этапе публикации схемы. Если события передаются в JSON без строгой схемы, страховкой остаются контрактные тесты.
Доставка сообщения еще ничего не доказывает: нужно убедиться, что получатель правильно понял данные и система пришла в ожидаемое состояние.
Как найти дефект на стыке сервисов
Когда ошибка проявляется в конце длинной цепочки, есть соблазн сразу идти к последнему сервису. Он записал неправильный статус — значит, искать нужно там.
На практике такой подход часто отнимает время. Последний компонент мог всего лишь обработать то, что ему передали.
Диагностику я начинаю с восстановления пути операции.
В нашем сценарии отправная точка — идентификатор заявки. Сначала проверяем ее исходное состояние в PostgreSQL сервиса заявок. Затем находим соответствующее событие в Kafka и смотрим содержимое сообщения: идентификатор, тип события, значение consent, версию схемы, если она предусмотрена.
Здесь появляется первое подозрение: отправитель передал булево значение вместо строки.
Но одного подозрения недостаточно. Нужно проверить, что потребитель действительно использует прежний контракт.
Смотрим логи обработчика, сопоставляем события по идентификатору заявки, времени и доступным корреляционным данным. Если в системе реализована распределенная трассировка, она помогает связать операции разных компонентов. Если нет — приходится восстанавливать последовательность по тем данным, которые доступны.
В логах нет исключения, зато в базе потребителя заявка получила REJECTED.
Следующий шаг — воспроизведение. В контролируемом тестовом окружении отправляем сообщение со старым значением «Y» и с новым true, сохраняя остальные условия одинаковыми. В первом случае обработчик выбирает ожидаемую ветку, во втором отклоняет заявку.
Вместо расплывчатого «интеграция работает неправильно» у нас есть конкретная причина: несовместимое изменение типа поля и правило обработки на стороне потребителя.
С таким описанием смежной команде понятно, что исправлять, как воспроизвести дефект и чем подтвердить исправление.
При этом маппинг — лишь одна из возможных причин. Интеграционные ошибки возникают и при повторной обработке сообщений, нарушении ожидаемой последовательности событий, задержках и расхождениях между промежуточным и конечным состоянием данных.
С Kafka легко спутать успешную публикацию с успешным выполнением операции.
Например, потребитель может записать результат в базу, но завершиться до фиксации обработанного смещения. После перезапуска сообщение будет прочитано повторно. Если обработчик не защищен от повторного выполнения, бизнес-действие рискует продублироваться.
Для критических операций проверяют идемпотентность обработки и механизмы защиты от дублей. Какие именно — зависит от архитектуры: это могут быть идентификаторы операций, ограничения уникальности в базе или другие согласованные решения.
QA не обязан проектировать эти механизмы вместо разработчиков. Но он должен понимать, какую гарантию дает система и как ее проверить.
Есть и другая тонкость. Kafka сохраняет порядок сообщений внутри партиции, а не во всем топике. Если последовательные изменения одного бизнес-объекта попадают в разные партиции, рассчитывать на общий порядок обработки нельзя.
Для системы, где статус операции должен изменяться в строго определенной последовательности, это уже бизнес-риск.
Что проверять, если до релиза осталось мало времени
На крупных проектах проверить абсолютно все невозможно. Сервисов много, зависимостей еще больше, а релизное окно ограничено.
На позиции Lead QA приходится решать, какие проверки действительно нужны до выпуска, а какие можно отложить без неприемлемого риска.
Количество пройденных тест-кейсов я не считаю главным показателем готовности. Можно выполнить сотню проверок второстепенной функциональности и пропустить изменение одного поля, которое используют несколько систем.
Планирование начинается с анализа изменений.
В случае с consent первый вопрос — кто еще потребляет событие application.created, поддерживают ли эти обработчики новый формат и какие бизнес-сценарии зависят от результата.
Изменение контракта сразу делает приоритетной проверку совместимости с потребителями. Для критической операции нужно подтвердить конечный результат, а если обработка допускает повторы, убедиться, что они не дублируют бизнес-действие.
При этом я не предлагаю превращать каждый релиз в полный end-to-end-регресс всей платформы. Такие проверки дороги в сопровождении, зависят от доступности окружения и не всегда помогают быстро локализовать дефект.
Нужен баланс: контрактные проверки на границах компонентов, интеграционные тесты измененных взаимодействий и сквозные сценарии для наиболее важных бизнес-операций.
Отдельный вопрос — тестовое окружение. Когда смежный сервис недоступен, команда использует заглушку. Мне не раз приходилось писать такие заглушки самому. Это нормальный способ проверить локальную логику, но он не доказывает совместимость с реальным потребителем.
В нашем примере заглушка может спокойно принимать true, пока настоящий обработчик ожидает «Y». Все тесты пройдут, а интеграционный дефект останется.
В оценке релиза стоит отдельно указывать границы проверок: что проверено на реальных компонентах тестового контура, что — с заглушками, а какие зависимости остались непроверенными.
Как объяснить бизнесу, почему релиз опасен
Фраза «мы нашли баг, релиз выпускать нельзя» редко помогает договориться с бизнесом. Следующий вопрос предсказуем: что конкретно сломается?
Вернемся к сценарию с consent.
Допустим, перед релизом выяснилось, что отправитель публикует новое представление поля, а потребитель продолжает использовать прежнюю логику. В результате заявки могут получать неправильный статус.
С таким набором фактов уже можно идти на обсуждение:
- Сервис заявок изменил формат поля в событии application.created.
- Действующий потребитель не поддерживает новое значение.
- При воспроизведении заявка получает REJECTED вместо ожидаемого статуса.
- Без исправления несовместимости этот бизнес-сценарий останется нарушенным после выпуска.
После этого спор о серьезности дефекта обычно заканчивается, и команда переходит к вариантам.
Можно вернуть прежний формат до обновления потребителей. Можно сначала выпустить потребитель с поддержкой обоих вариантов, а затем изменить отправитель. В некоторых системах допустимо временно отключить затронутую функциональность.
Но любое решение нужно проверять. Feature flag не исправляет уже некорректно обработанные данные, а откат версии приложения не обязательно отменяет опубликованные события и изменения в базе.
Оценивая релиз, я учитываю, насколько быстро ошибку обнаружат, можно ли ограничить последствия и потребуется ли восстановление данных.
Перенос релиза — нормальное решение, если известный риск нельзя устранить или приемлемо ограничить до выпуска.
Моя задача — предоставить технические доказательства и объяснить последствия. Окончательное решение принимают те, кто отвечает за релиз.
Готовность сервиса и готовность продукта
Микросервисная архитектура позволяет командам развивать компоненты независимо, но пользователь не видит топиков Kafka и обращений к базе. Он видит, обработана ли заявка, прошел ли платеж и верен ли расчет. Интеграционное тестирование проверяет, сохраняет ли система правильное поведение после обмена данными. Если операция ломается на шаге после успешно отработавшего сервиса, выяснить это нужно до релиза.