





Сегодня каждая вторая дорожная карта ИТ-директора содержит пункт о внедрении ИИ-инструментов для разработки. Ожидания завышены, поскольку аналитики сулят рост производительности на 40%, мгновенное сокращение времени на рутину, выход команд на новый уровень. Однако на практике мы видим иную картину, где пилотные проекты завершены, инструменты закуплены, сделаны большие инвестиции в инфраструктуру, а взрывной трансформации не произошло. Разработчики используют нейросети, но релизы не ускоряются, архитектурные решения не становятся элегантнее, а технический долг не испаряется мгновенно.
Заявленные 40% — это миф, но с оговоркой. Да, на отдельной операции по написанию кода ИИ способен дать такое ускорение. Однако программист тратит на написание кода лишь около 30% своего времени. Поэтому общий прирост продуктивности отдельного специалиста редко превышает 10%. Компании ошибочно подменяют системную трансформацию процессов точечной автоматизацией задач, забывая про остальные 70% рабочего времени и контекст enterprise-разработки. Производительность — свойство системы, а не сумма индивидуальных эффективностей.
Ловушка ложных метрик
Первая и фундаментальная ошибка — отсутствие целеполагания и, как следствие, измерение успеха не теми показателями. Сначала нужно определить цель внедрения ИИ в разработку, и уже она должна задавать метрики. Если цель —просто адаптация технологий и соответствие модным веяниям, тогда метрика — процент кода, написанного при помощи ИИ, и количество разработчиков, которые этим пользуются. Но такие метрики ничего не говорят об экономической эффективности и, скорее всего, порождают дополнительные расходы. Если метрика — time-to-market, то при подходе, когда разработчик лишь немного использует ИИ как ассистента, общий time-to-market не улучшается, потому что оптимизация происходит на уровне тех самых 30% написания кода. Даже если ускорить их на 20%, это даст около 6% общего выигрыша — эффект на уровне погрешности. Если речь про экономику, то есть про общую стоимость владения командой разработки, то при таком подходе она, будучи правильно посчитанной, не улучшится:
Если же говорить о повышении качества кода и удовлетворенности клиентов, то прямой корреляции с использованием ИИ нет. Соответственно, при такой логике — как плагин к старым процессам или примочка к имеющемуся разработчику — эффект в основном получит сам разработчик: ему станет веселее, комфортнее, он получит новую компетенцию. Компания же в целом на своем SDLC-цикле не сможет наблюдать эффект на уровне общеорганизационных показателей.
Фокус на активности, а не на результате создает искаженную реальность. У разработчика нет плана по сгенерированному коду — у него план по функциональности. Проблема не в том, что ИИ оставляет шаблонные артефакты как таковые. При внедрении ИИ как плагина к старым процессам эффективность на уровне индивида может вырасти, а пропускная способность команды — остаться прежней или даже упасть. Происходит это потому, что ИИ внедряется как плагин к старым процессам и не является значимым поводом их пересмотреть.
Провал контекста
Вторая причина — фундаментальный разрыв между универсальностью публичных языковых моделей и уникальным контекстом enterprise-разработки. Мощный ИИ, обученный на открытых репозиториях, прекрасно справляется с типовыми задачами и созданием готовых решений с нуля. Но интеграция ИИ в уже существующий ландшафт и имеющиеся процессы, где современные новые системы сочетаются с legacy-архитектурой, спроектированной и созданной
С учетом разнообразия систем и инструментария единообразно внедрить ИИ во все процессы разработки на всех языках и технологиях, которые использует компания, не получится: бэкенд — это один стек, фронтенд — другой, учет и бухгалтерия — третий. Условно пятипроцентный эффект в скорости будет заметен только там, где очень много людей работает на одной и той же технологии, в одном стеке, одной системе — когда их количество измеряется тысячами. Если же на монотехнологии сидят десятки или до сотен человек, достижимый эффект незначителен, а расходы на интеграцию в разные технологические стыки и их связь между собой огромны.
Без тотальной перестройки процессов разработки и, возможно, перегенерации целых модулей и даже систем с нуля нужного эффекта не достичь. Это снова смена процесса: мы не даем айтишнику окошко с чатом, где он генерирует себе кусочки кода, а перестраиваем процесс целиком.
Теневая ИИ-экономика разработчиков: симптом системной проблемы
Парадоксально, но на фоне неудач корпоративных программ внедрения процветает теневая ИИ-экономика. Практически все разработчики сегодня в личном порядке используют ChatGPT, Copilot или аналоги для решения рутинных рабочих задач, например объяснения чужого кода, поиска ошибок или мозгового штурма. Со стороны руководства это часто воспринимается как угроза безопасности. И справедливо. Однако борьба с этим явлением запретами стратегически ведет в тупик.
Стихийное использование ИИ — четкий сигнал о наличии спроса, который официальные корпоративные инструменты не удовлетворяют. Они оказываются недостаточно интегрированными в рабочий контур (тот же pipeline CI/CD), не адаптированными под внутренние практики или просто неудобными. Запрещая теневые инструменты, компания не решает проблему, а загоняет ее вглубь, теряя контроль над данными и упуская возможность направить энергию команды в управляемое русло. Это классический пример тактики страуса, которую мы уже проходили с облачными сервисами десять лет назад.
Стратегия прорыва
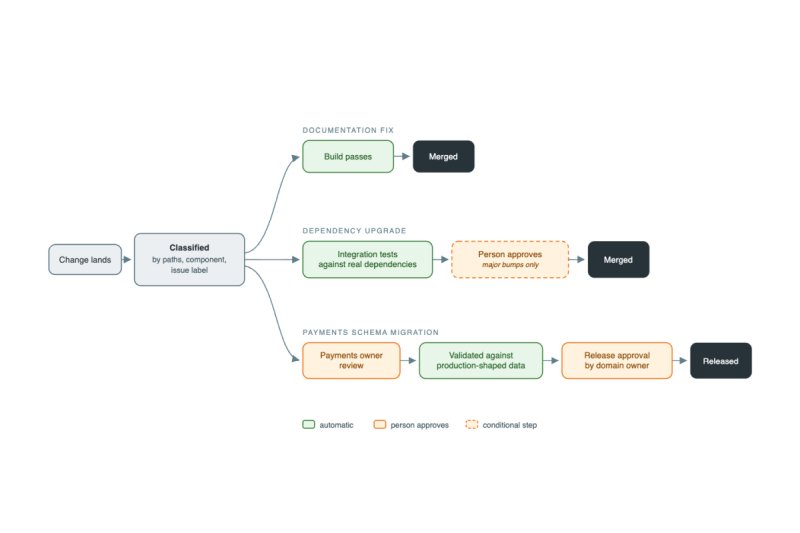
Чтобы изменить эту сомнительную практику, необходим переход от логики внедрения ИИ к логике инжиниринга процессов с ИИ. Это требует трех последовательных действий, основанных на принципе стратегического соучастия, а не запрета.
Важно разделять два сценария. Первый — ИИ как персональный ассистент разработчика. Это дает локальный 5-10%-ный эффект, но не меняет систему. Второй — создание автономных ИИ-фабрик, где агенты последовательно проходят весь SDLC-цикл: от анализа требований до приемки. В этом случае меняется ролевая модель команды: люди становятся оркестраторами и архитекторами. Именно второй путь ведет к взрывному росту, но требует перестройки не кода, а процессов. Ниже шаги, которые работают в обоих сценариях.
Шаг 1. Легализация и безопасный канал
Важно сперва признать реальность и создать для разработчиков безопасную, контролируемую среду для экспериментов. Технически это реализуется через корпоративный «гибридный шлюз», единую точку входа для всех ИИ-запросов. Его задача заключается в интеллектуальной маршрутизации: публичные, некритичные запросы идут в одобренные внешние модели, а работа с чувствительным кодом, архитектурой или данными перенаправляется в изолированные, внутренние sandbox-среды. Это немедленно снимает остроту рисков ИБ и, что важнее, дает руководству беспрецедентную видимость того, какие задачи команды пытаются решить с помощью ИИ, где лежат их главные боли.
Шаг 2. Инвестиции в контекст, а не в генерацию
Вместо покупки лицензий на универсальные модели ресурсы должны направляться на создание специализированных ИИ-агентов, встроенных в жизненный цикл разработки. Речь о постепенном внедрении ИИ-агентов в SDLC-процессы — точечных помощников, обученных на вашей собственной кодовой базе, документации и истории, — с последовательным рефакторингом всего процесса SDLC и приучением разработчиков и инженеров к тому, что ИИ-агенты появляются на всех этапах жизненного цикла разработки программного обеспечения.
Альтернативным вариантом может быть дизайн SDLC с нуля и постепенный перевод на него отдельных команд и технологий, наиболее пригодных и готовых к внедрению ИИ-агентов в разработку:
● Агент для анализа и рефакторинга legacy-кода, понимающий вашу специфику.
● Интеллектуальный ревьюер, знающий внутренние стандарты и типовые уязвимости домена.
● Контекстный помощник по архитектуре, способный предлагать решения в рамках утвержденных паттернов.
Именно такие агенты дают измеримый эффект, сокращая время на анализ, снижая количество дефектов и повышая согласованность кода. Их ключевое свойство — обучаемость на основе обратной связи команды.
Шаг 3. Верификация системы измерений, исходя из целеполагания компании
Финансирование и оценка успеха должны быть жестко привязаны не к фиксированному набору метрик, а к целеполаганию компании.
Сначала формулируется цель, под нее определяются метрики. Кто-то говорит: «Меня устраивает time-to-market, надо, чтобы все было так же, но дешевле». Кто-то готов тратить в два раза больше, но ускорить вывод продуктов в 10 раз, потому что по бизнесу это позволит зарабатывать гораздо больше и обгонять конкурентов. У кого-то ключевой критерий — трансформация командной разработки и ее реализация, и это считается самостоятельной ценностью; тогда параметры — объем использования и т. п. Поэтому эффективность ИИ должна доказываться влиянием на эти показатели, а не на объем сгенерированного текста.
Производительность как инженерная дисциплина
Миф о 40% развеивается простым, но неудобным выводом: производительность нельзя купить как коробочный продукт. Генеративный ИИ — не волшебная таблетка, а сложный и требовательный компонент, который работает только при перестройке процессов, инвестициях во внутренние компетенции и зрелой культуре данных. Взрывного роста не будет: настоящая эффективность — результат системной инженерной работы, а не единичного внедрения.
Будущим технологическим лидерам предстоит не «внедрить ИИ в разработку», а перепроектировать сам процесс разработки, где ИИ становится одним из ключевых инженерных приемов. И здесь критически важно не совершить стратегическую ошибку — не отказаться от джуниоров в пользу ИИ. Молодые специалисты — это инвестиция в кадровый резерв. Их роль меняется: они учатся не столько писать шаблонный код, сколько управлять агентами и контролировать их работу. Трансформация SDLC не отменяет необходимости выращивать собственную экспертизу.
Более того, молодые специалисты без большого опыта разработки и доработки систем быстрее схватывают саму идею генерации готовых систем и функциональных блоков с нуля. У них нет груза прежних привычек или он невелик, поэтому они легче принимают мысль, что готовые решения можно генерировать. Разумеется, речь не о больших бизнес-критичных системах. Но внутренняя автоматизация, порталы, борды и другие задачи, на которые раньше не хватало ресурсов или которые оставались недоинвестированными — например, красивый портал проектного управления, — сегодня могут решаться молодыми специалистами гораздо эффективнее. Опытному программисту, привыкшему много писать код, задача генерации внутренних готовых решений часто неинтересна, а молодежь уже создает работающие системы внутренней автоматизации и внутренней эффективности. Реальных примеров много, и поэтому недооценивать джунов в задачах внедрения ИИ в разработку нельзя.
Путь к реальному росту производительности лежит не в покупке инструментов, а в соединении инженерной дисциплины, зрелых процессов и ставки на новое поколение специалистов.