




С осени 2025 года у Apache Flink есть подпроект Flink Agents, который встраивает нейросети прямо в потоковую обработку данных. Что это меняет и сможет ли нейросеть заменить дежурного инженера?
Проблема, которую все знают, но терпят
Типичная ситуация: ночью срабатывает алерт — дежурный инженер должен устранить неполадки. Чтобы добраться до проблемы, ему нужно проснуться, войти во внутреннюю сеть компании, открыть графики и логи, понять, какое приложение сломалось и почему. На это уходит много времени.
Решение при этом чаще всего простое: перезапустить приложение, выделить ему больше ресурсов или откатить на предыдущую версию. Почти всё время тратится на подход к исправлению, а не на само решение. На проблему, которую можно было решить за секунды, тратятся десятки минут, иногда дольше.
Системы усложняются с каждым годом, связей между приложениями становится больше, и сбой в одном месте всё чаще тянет за собой проблемы в другом. Индустрия вкладывает много сил в отказоустойчивость: системы дублируют и разносят по разным площадкам. А вот реакция на аварию почти не изменилась: дежурный по-прежнему смотрит на проблему своими глазами, разбирается и действует. В такой ситуации он становится «узким местом». Аварии случаются под нагрузкой, когда каждая минута простоя стоит дороже всего. После такой ночи инженер не высыпается и на следующий день работает хуже, поэтому одна авария обходится компании дважды.
Инструкции устаревают быстрее, чем их пишут
Чаще всего дежурному помогают плейбуки. Идея понятная: записать опыт один раз, чтобы им воспользовался любой инженер. Однако плейбук устаревает почти сразу: системы меняются каждую неделю, а инструкции в лучшем случае правят раз в год. Несколькими плейбуками современную систему не покрыть: нужна целая энциклопедия, которую никто не успевает поддерживать.
Я не помню, когда последний раз вообще видел плейбуки, но точно знаю: системы, для которых их писали, были гораздо проще и менялись гораздо реже, чем нынешние. На вопрос «А где же ваши плейбуки?» сегодня нередко можно услышать, что их либо нет, либо те, что есть, безнадёжно устарели.
Логичный следующий шаг — прикладывать к каждому алерту пояснение, что он означает и что делать. Но на практике этот подход быстро упирается в противоречие:
— Узкие алерты привязаны к конкретной причине. Представим кластер Flink, на котором работают десятки джоб. Каждая может упасть по-своему: ошибка в пользовательском коде, некорректное сообщение в Kafka, потеря соединения с базой данных, нехватка ресурсов, сбой Kubernetes, ошибка JVM. Под каждую причину легко написать инструкцию, но такие ошибки часто приходят группой, и одна проблема — джоба перестала обрабатывать данные — превращается в пять алертов. Внимание дежурного размазывается, и главное теряется в шуме.
— Общие алерты описывают симптом, а не причину, например «джоба не обрабатывает данные». На одну проблему приходит один алерт, и дежурный сразу видит, что сломалось. Но к такому алерту уже не напишешь инструкцию: у симптома может быть десяток причин.
Поэтому многие команды в итоге переходят на общие алерты: внимание дежурного не размазывается, а одна проблема — это один сигнал. От формальных инструкций при этом приходится отказаться, и новых дежурных учат через наставничество. Решение неидеальное, но на практике оно работает лучше остальных. Но главная беда никуда не девается: чтобы понять, что случилось, по-прежнему нужно много времени.
Что изменилось
Данных для разбора аварии у инженеров обычно достаточно. Логи приложений стекаются в единую систему передачи сообщений, например Kafka. К ней подключают потоковый обработчик — джобу на Apache Flink, которая читает логи в реальном времени.
Раньше такой обработчик выполнял только заранее прописанные реакции: например, если за минуту пришло больше ста ошибок нехватки памяти, перезапусти приложение. Это тот же плейбук, только в коде. Он быстрее бумажного, потому что убирает человека из цепочки, но устаревает так же: система меняется, а правила остаются.
Теперь в тот же поток можно встроить языковую модель и дать ей инструменты через MCP (Model Context Protocol) — стандартный протокол, через который модель обращается к внешним системам. Модель понимает текст ошибки, сама запрашивает метрики, историю релизов, состояние приложения в Kubernetes и по ним предлагает, что делать. В этом и состоит сильная сторона нейросетей: они быстро собирают разнородные данные в одну картину.
Время реакции сокращается с десятков минут примерно до минуты. Большую часть этого времени занимает накопление событий перед отправкой в модель. Ответ модели и пара обращений к инструментам занимают секунды.
Как это устроено
Разберём на примере Apache Flink Agents — подпроекта Flink, в котором агент становится обычным шагом потоковой обработки.
Если упростить, конвейер состоит из трёх ступеней:
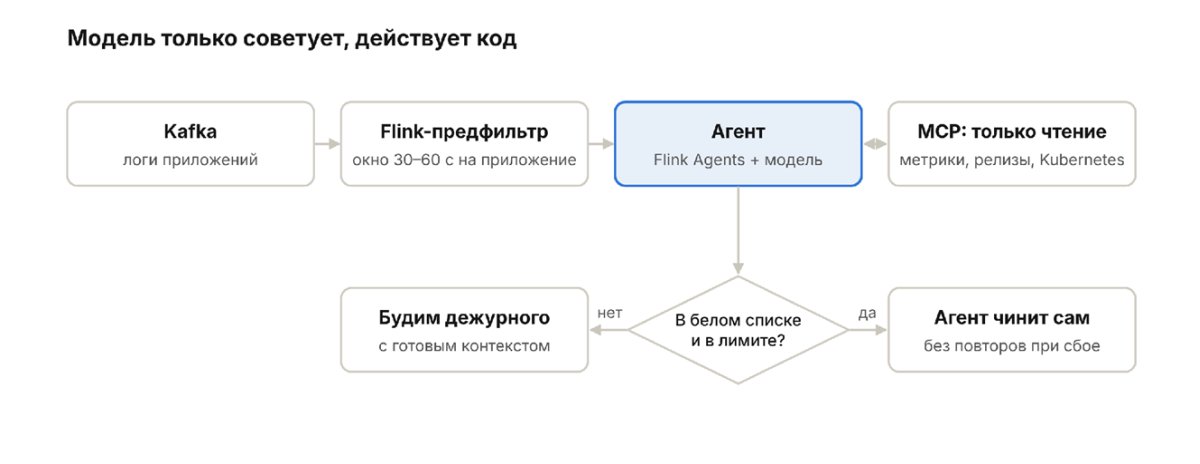
1. Дешёвый предфильтр без модели. Предфильтр группирует логи из Kafka по приложению и накапливает их в окне на
2. Агент. Агент состоит из событий и действий. Событие — сигнал, что что-то произошло, например пришло новое происшествие. Действие — небольшой фрагмент логики, который запускается на определённое событие и порождает новое. Для типовых шагов есть готовые события: вход, запрос к модели, ответ модели и выход. Если модели нужны инструменты, фреймворк сам вызывает их и возвращает результат, пока у модели не будет готового ответа.
Разработчик описывает всё, чем агент пользуется, отдельно от логики, как набор ресурсов: какая модель, какой промпт, какие инструменты, какие MCP-серверы. Ресурсы выносят в конфигурационный файл и, например, меняют поставщика модели, не трогая код.
Фреймворк поддерживает два стиля: workflow-агент, где маршрут задаёт разработчик, и ReAct-агент, где модель сама решает, какой инструмент вызвать следующим. Для аварий удобнее первый: каркас жёсткий, а свободу выбирать инструменты модель получает только на шаге диагностики.
Здесь важны три вещи.
— Модель сама ничего не меняет. Ей доступны только инструменты на чтение. Исправление выполняет наш собственный код, и только если предложенное действие есть в белом списке, а лимит не исчерпан. Модель советует, код действует.
— Ответ модели — в строгом формате. Модель возвращает заранее описанную структуру: что случилось и какое действие она предлагает. Всё, что код не смог разобрать, автоматически уходит человеку.
— Действие не выполнится дважды. Flink Agents запоминает результат действия во внешнем хранилище (Kafka или Apache Fluss), поэтому, если джоба упадёт и восстановится, повторного перезапуска не будет. Для самого неприятного случая, когда перезапуск уже выполнен, а записать результат система не успела, можно задать отдельную проверку: при восстановлении фреймворк сначала спросит у Kubernetes, в каком состоянии приложение.
3. Выход. Агент отправляет результат в отдельный топик Kafka, а оттуда он попадает в систему оповещений и в тикет. Если агент справился сам, в журнале появляется запись. Если нет, дежурный получает алерт с приложенными метриками, последними релизами и гипотезой модели о том, что случилось.
Где граница доверия?
У этого подхода есть обратная сторона: доверие к нейросети. Очевидный ответ такой: машине отдаём только то, что безопасно и легко откатить, всё остальное она готовит, а решает человек. Нейросеть заменяет рутину инженера. Самого инженера она заменить не может. Границу удобно описать таблицей прав (цифры приведены для примера):
|
Действие |
Кто выполняет |
Ограничения |
|
Сбор данных: метрики, логи, релизы, состояние в Kubernetes |
Агент сам |
Только MCP-сервер на чтение, отдельная служебная учётная запись |
|
Перезапуск приложения |
Агент сам |
Не чаще 2 раз в час на приложение; не помогло — зовём человека |
|
Масштабирование |
Агент сам |
В пределах квоты, например не больше чем +50% копий приложения |
|
Откат релиза |
Агент в узких рамках, иначе человек |
Только на предыдущую версию и только для свежего релиза |
|
Конфигурация, базы данных, сеть, удаление ресурсов |
Только человек |
Агент прикладывает собранные данные и предложение |
Чтобы эта схема работала, нужно несколько вещей.
Права ограничиваются в инфраструктуре. Flink Agents автоматически подтягивает все инструменты подключённого MCP-сервера. Список в настройках определяет, какие из них увидит модель, но это одна строчка, в которой легко ошибиться. Надёжнее, когда опасных операций на сервере нет вообще, а служебная учётная запись имеет права только на чтение.
Лимиты против зацикливания. Если перезапуск не помог, второй и третий, скорее всего, тоже не помогут, зато замаскируют настоящую проблему. Поэтому поток хранит счётчик действий по каждому приложению в своём состоянии, и при превышении лимита агент обязан позвать человека.
Маленькие модели. Если отправлять каждое событие в самую мощную модель, мы либо разоримся, либо будем подолгу ждать ответа. Поэтому здесь обычно работают небольшие модели: большой контекст им не нужен, но и доверить им можно далеко не всё.
Уверенность модели не равна вероятности. Если попросить обычную языковую модель оценить свою уверенность, она вернёт число, которое, по сути, сама и придумала. Поэтому решение «чинить самому или звать человека» стоит строить на белом списке и лимитах, а не на такой оценке. Здесь интересен новый класс моделей, которые не пишут текст, а выбирают из заданных вариантов. Пример — Jev от TypeSafe AI, вышедшая 15 сентября 2026 года. Ей передают собранные данные и варианты вроде «перезапустить», «добавить ресурсов», «позвать человека», а она возвращает выбор с вероятностью, которую разработчик называет калиброванной, причём, по его данным, за
Теневой режим. Начинать стоит с режима, в котором агент предлагает, а действует человек. Пару недель мы сравниваем решения агента с решениями дежурных и только потом включаем автоматику по одному типу действий, начиная с самого безопасного.
Главное правило: никаких неограниченных прав. Иначе однажды мы проснёмся и узнаем, что нейросеть сочла проблемой всю нашу систему и аккуратно её устранила. Это шутка, но с долей правды: агент может ровно то, что ему разрешили.
Плейбук, который пишет себя сам
Вернёмся к ночи из начала. В логах одного из сервисов начинают сыпаться ошибки. Предфильтр сворачивает их в одно происшествие. Агент запрашивает метрики, видит, что потребление памяти дошло до лимита, а новых релизов за сутки не было, и предлагает перезапуск. Перезапуск есть в белом списке, лимит не исчерпан, поэтому код выполняет его сам. С первой ошибки проходит около минуты, и дежурный даже не просыпается.
Утром инженер видит отметку «авария устранена» и полный след решения: что пришло на вход, какие инструменты вызвал агент и что они вернули, почему он выбрал перезапуск. Flink Agents пишет каждое событие, включая обращения к модели и инструментам, в журнал, который с версии 0.3 по умолчанию виден в веб-интерфейсе Flink. Длинные записи в нём по умолчанию сокращаются, поэтому для полного следа нужен подробный режим.
Это плейбук нового типа. Инструкция выполняется в момент проблемы и смотрит на систему в реальном времени, а документ поддерживать не нужно.
Поддерживать что-то всё-таки придётся: короткий список разрешённых действий, лимиты и промпт. Энциклопедия на сотни страниц не нужна. Такой список легко проверять на ревью, хранить в git и прогонять на записанных прошлых инцидентах.
Сколько подъёмов на самом деле требовали человека?
Нейросети уже забрали у инженеров много шума — работы, которая требует много сил, но даёт мало результата: тесты, документацию, мелкие исправления. Дежурство — тоже шум, только дорогой. Каждая такая ночь стоит компании денег, а инженеру — сил.
Проверить, сколько такого шума, просто. Откроем историю инцидентов за последний квартал и посчитаем, сколько из них закончились перезапуском, масштабированием или откатом. Это и есть доля ночей, в которых человек был нужен только для того, чтобы нажать кнопку.
Речь не о том, чтобы убрать дежурного, а о том, чтобы изменить его работу. Базовые случаи может закрывать сама система, а человеку остаётся то, что действительно требует опыта, и проектирование системы, которая реагирует сама. Это интереснее, чем вставать в три часа ночи ради одной команды.